

本文介绍阿里云百炼实时多模态交互 HarmonyOS SDK 的下载安装、关键接口和代码示例。
MultiModalDialog SDK 由阿里云千问团队提供,支持音视频端到端多模态实时交互。通过对接千问大模型及后端 Agent,可实现语音对话、天气查询、音乐、新闻等功能,并支持在大模型对话中使用视频和图像。
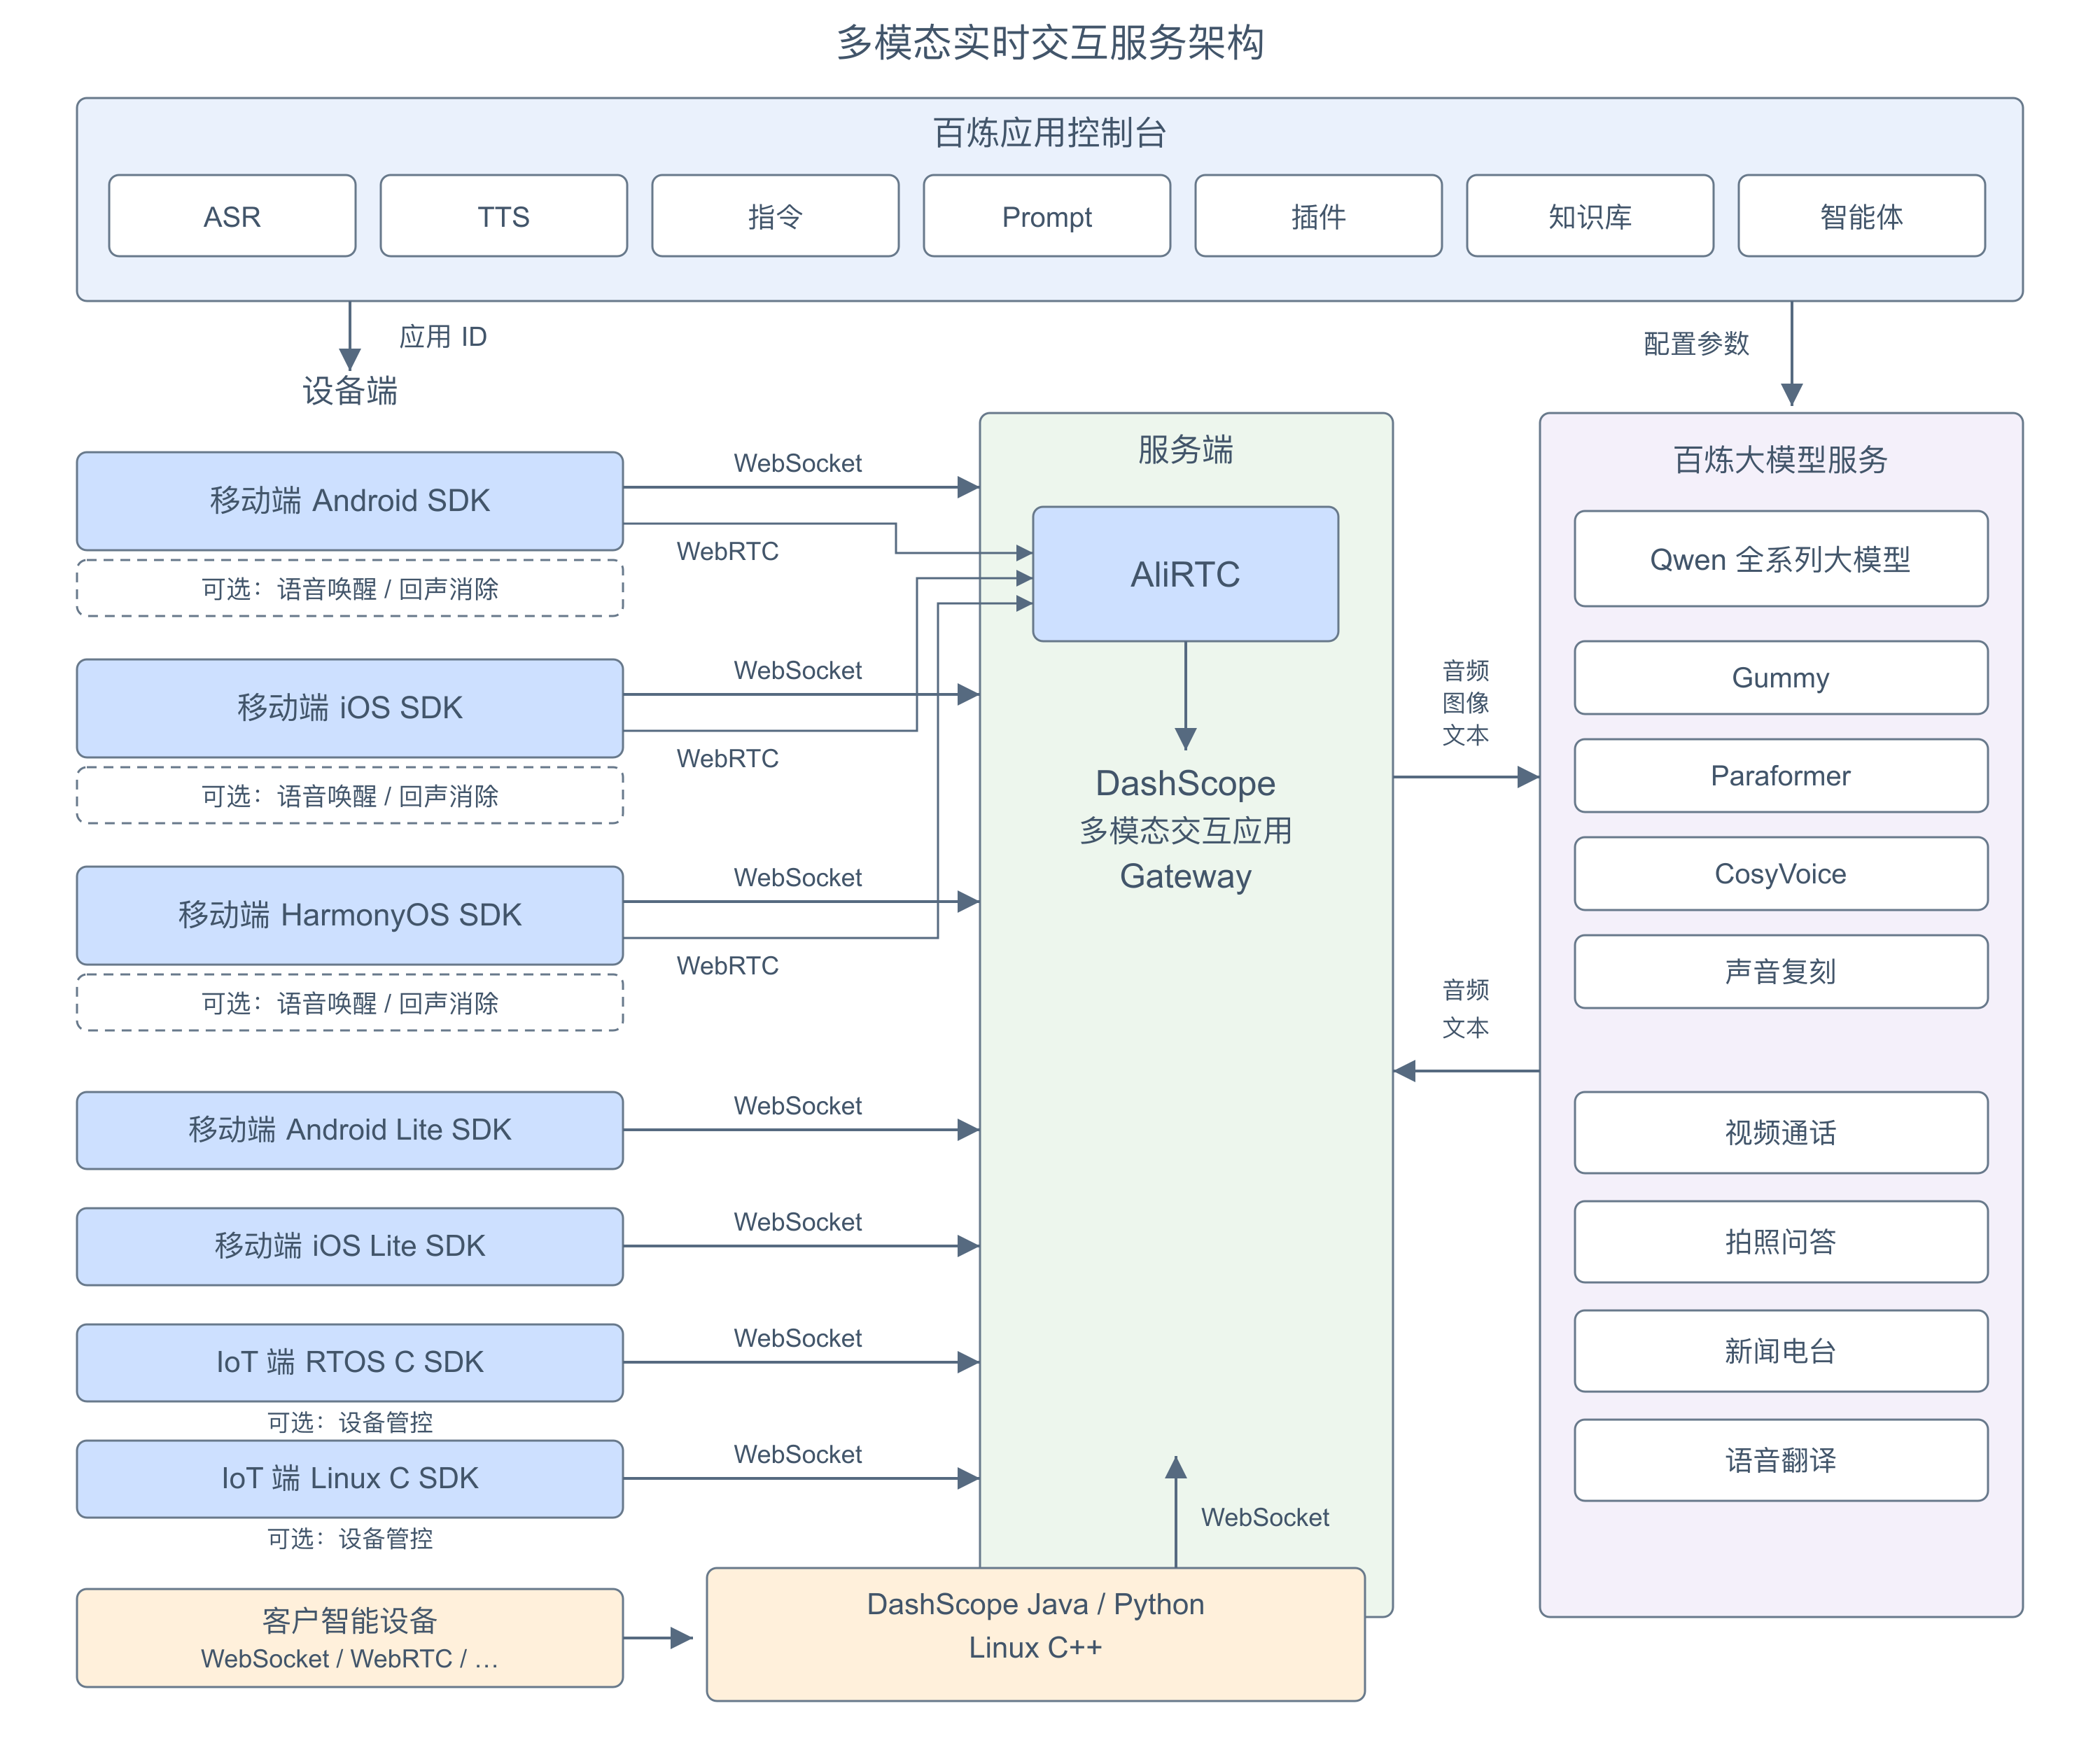
SDK 使用 WebSocket 协议与服务端交互,支持 AudioOnly 和 AudioAndVideo 两种模式:
SDK 支持 Push2Talk、 Tap2Talk和Duplex(全双工)三种交互模式:
HarmonyOS SDK 通过 har(Harmony Archive) 方式接入。发布产物工程 SDK 依赖如下:
HarmonyOS SDK 使用双链路:
连接与鉴权参数:
发布产物工程(
请求协议字段:
下表说明 SDK 发往服务端的请求结构,不是
parameters.upstream的参数说明如下:
parameters.downstream的参数说明如下:
parameters.client_info的参数说明如下:
parameters.biz_params的参数说明如下:
HarmonyOS 对话回调接口为
HarmonyOS SDK 通用错误码,如遇报错问题,请参见文档多模态实时交互错误码进行排查。
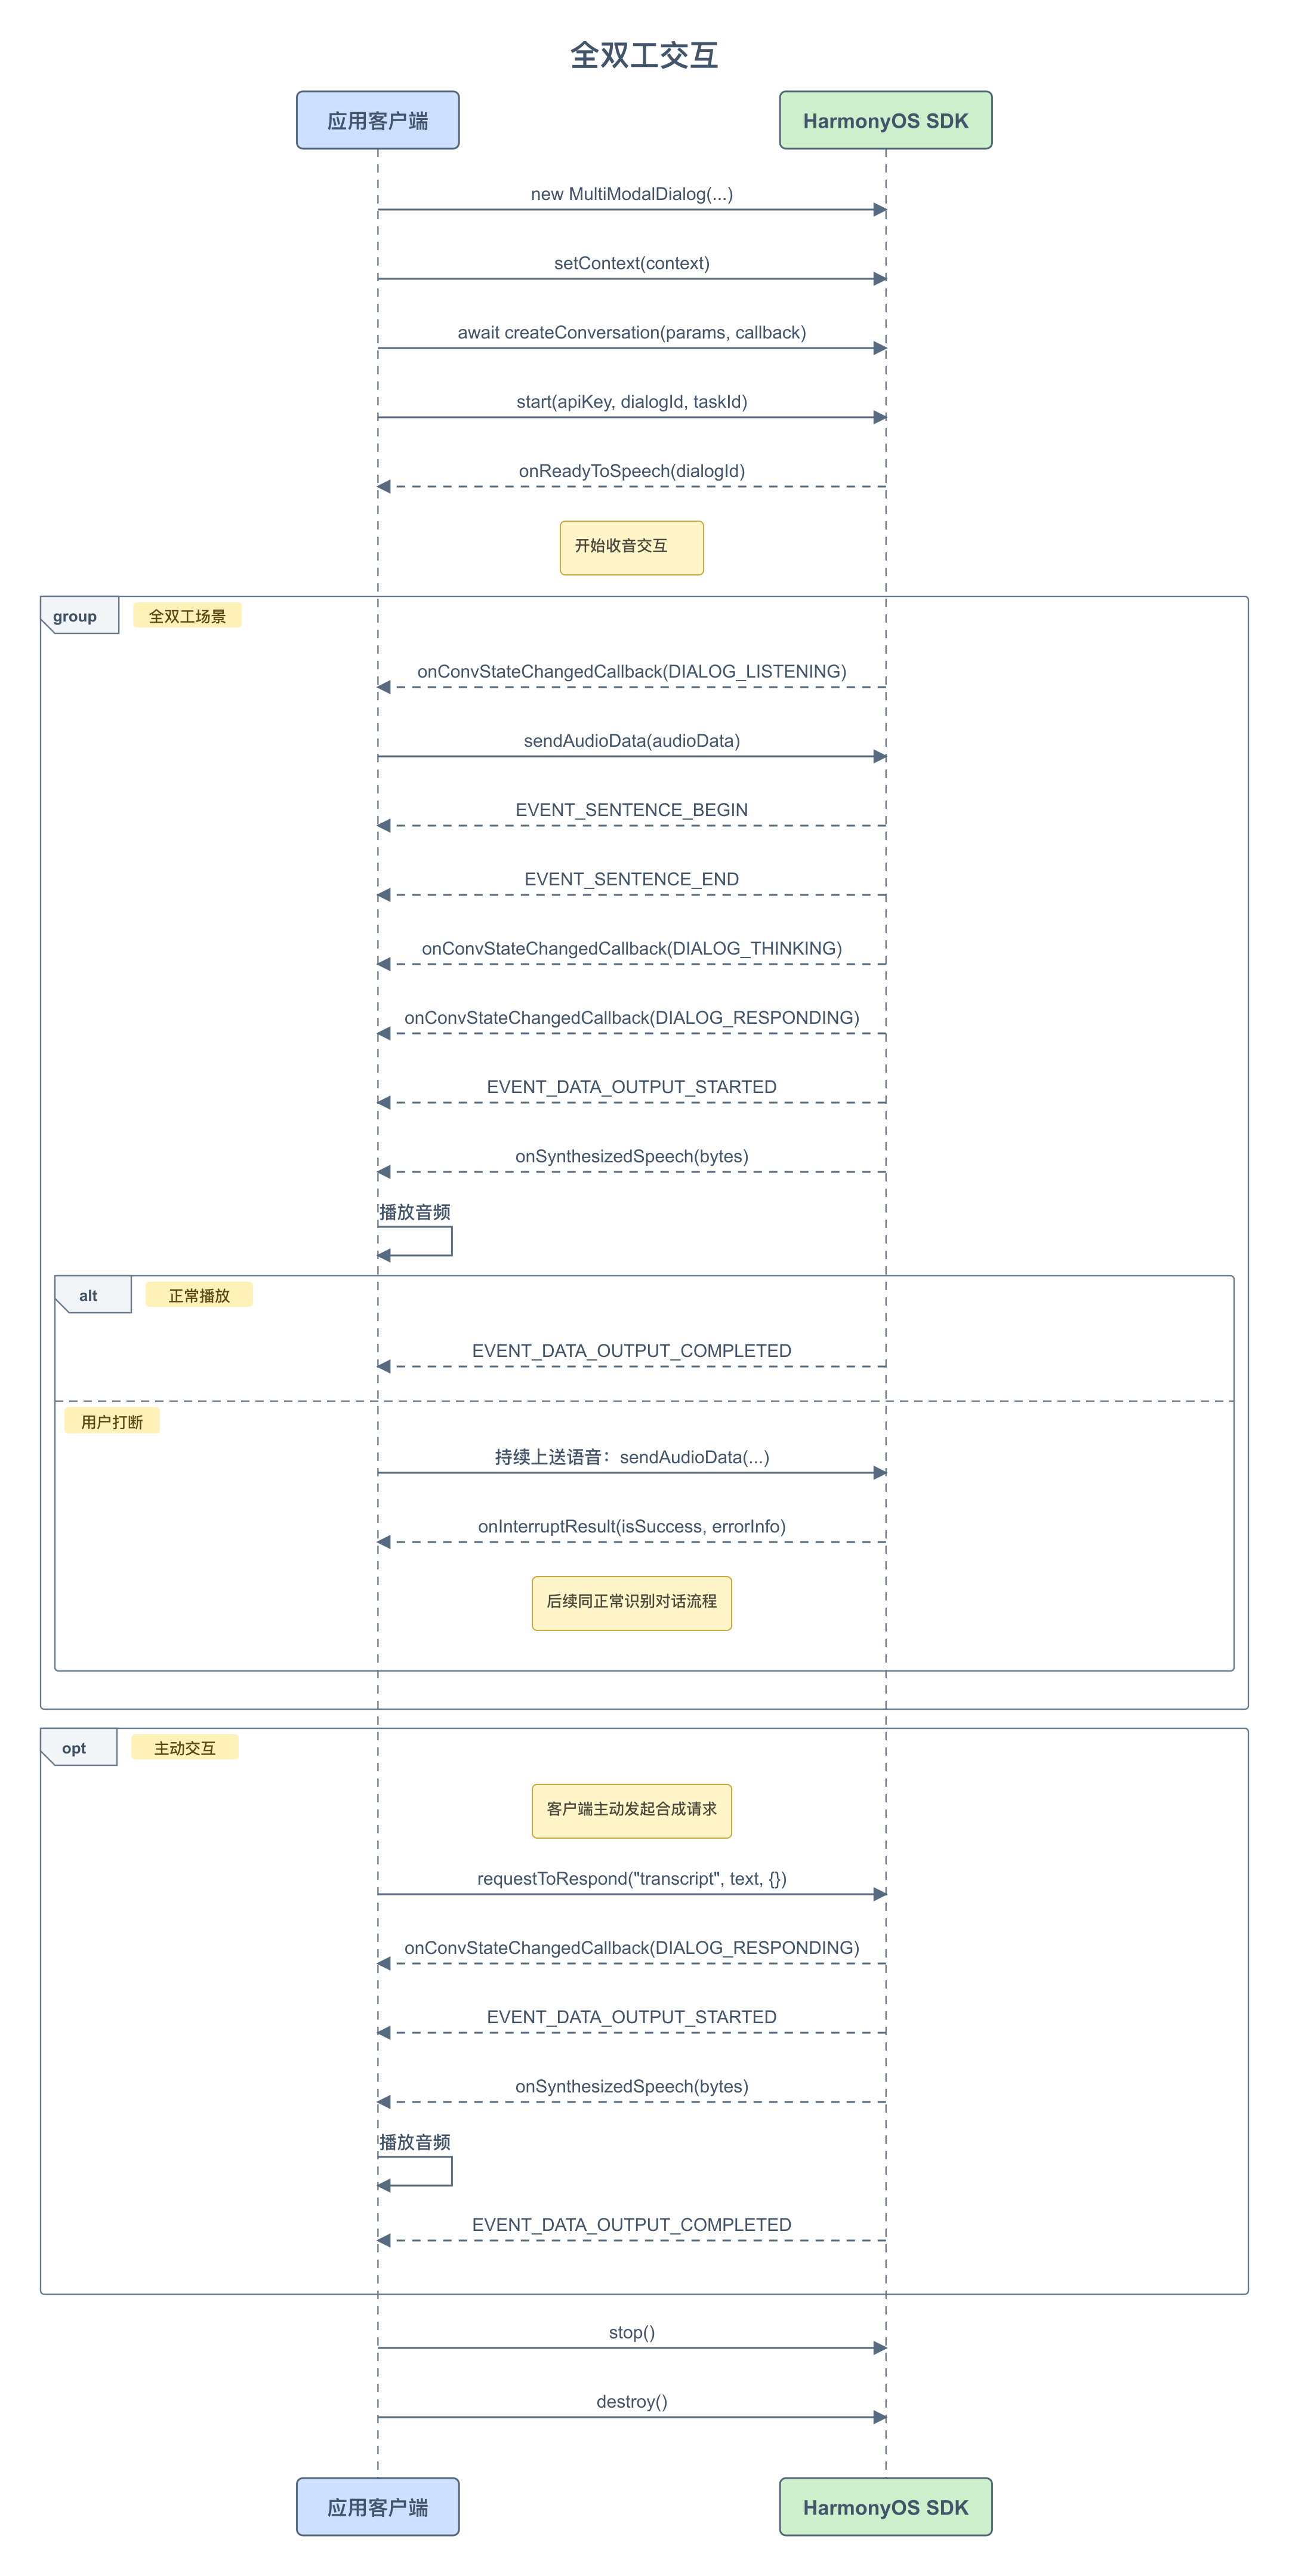 全双工(Duplex):WebSocket 链路下,由应用采集麦克风音频并通过
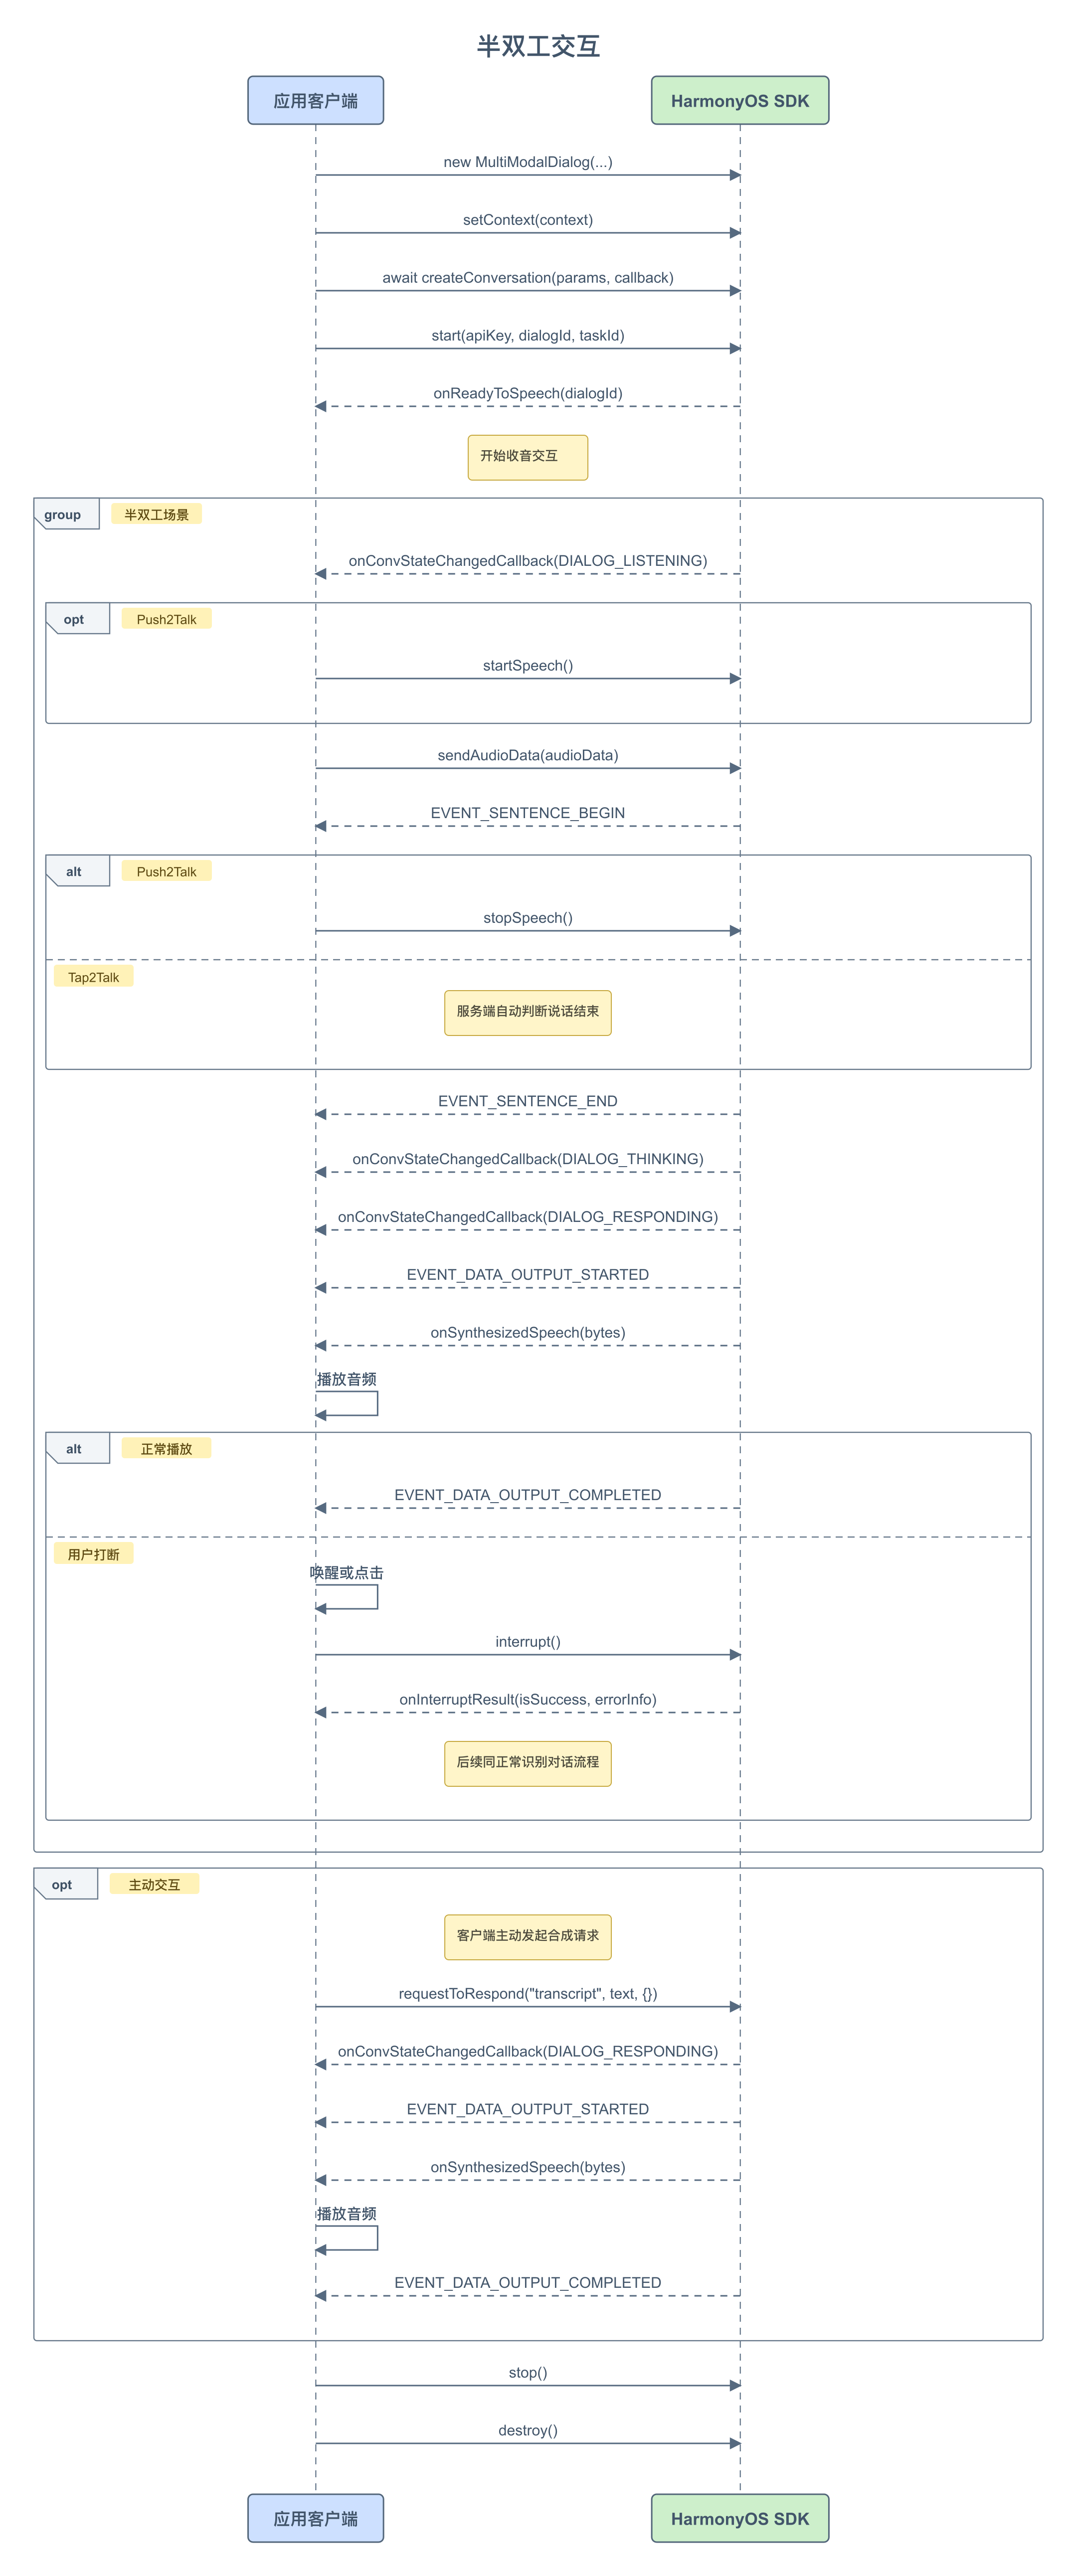 半双工(Push2Talk / Tap2Talk):Push2Talk 按住说话、松开结束;Tap2Talk 点击开始,由服务端自动判断说话结束。
HarmonyOS SDK 支持 Duplex 全双工交互模式。在 WebSocket 双工模式下,应用在播放 AI 语音回复时持续采集并上送录音,支持随时说话打断。
在双工模式下调用:
VQA 是在对话过程中通过发送图片实现图片+语音的多模交互的功能。
核心过程是语音请求拍照意图触发 "visual_qa" 拍照指令。当客户端通过回调
LiveAI(视频通话)是百炼多模态实时交互的官方 Agent。通过 WebSocket 链路调用 LiveAI 时,SDK 使用
注意:当前版本外部视频帧推送接口(
TTS 是文本合成语音的能力,HarmonyOS SDK 通过
在对话过程中,ASR 识别结果有可能出现错误或者非预期的结果。除了配置热词之外,也可以通过即时纠错功能接口上传纠错词表进行实时干预。
参数说明:
多模态实时交互服务架构
前提条件
- 使用阿里云百炼大模型服务提供的实时多模交互能力,需要:
- 开通阿里云百炼实时多模交互应用,获取Workspace ID、APP ID和API Key。
- 下载 HarmonyOS SDK 和 Demo,并配置必要的环境、依赖。
- 导入示例代码,按照调用流程接入 SDK。
- 可以直接运行发布产物工程(
multimodal-dialog-harmony-V1.4.9-V1.0.0)中entry模块的 HAP 测试程序,填入上方三个必要参数,即可进行测试。
| Package | Version |
|---|---|
| multimodal-dialog-harmony-V1.4.9-V1.0.0.tar.gz | V1.4.9-V1.0.0 |
SDK 接入
交互数据链路说明
SDK 使用 WebSocket 协议与服务端交互,支持 AudioOnly 和 AudioAndVideo 两种模式:
- 音频交互:仅支持音频和文本对话功能。
- 音视频交互:在交互中通过指令方式进入视频通话模式,客户端持续向服务端发送视频帧,实现端到端的音视频多模交互能力。
交互模式说明
SDK 支持 Push2Talk、 Tap2Talk和Duplex(全双工)三种交互模式:
- Push2Talk: 长按说话,抬起结束的收音方式。
- Tap2Talk: 点击开始说话,自动判断用户说话结束的收音方式。
- Duplex: 全双工交互,连接开始后支持任意时刻开始说话,支持语音打断。
调用说明
SDK 引用
HarmonyOS SDK 通过 har(Harmony Archive) 方式接入。发布产物工程 SDK 依赖如下:
- WebSocket 链路(
ChainMode.WEBSOCKET):支持 AudioOnly 和 AudioAndVideo 两种交互。 - RTC 链路(
ChainMode.RTC):音视频链路(LiveAI 视频通话)。
关键参数
连接与鉴权参数:
url、chainMode、workspaceId、appId 和 dialogMode 通过 MultiModalDialog 构造方法传入;apiKey 通过 start 或 startTwo 传入,不属于 MultiModalRequestParam。
| 一级参数 | 二级参数 | 类型 | 是否必选 | 说明 |
|---|---|---|---|---|
| url | string | 是 | 请求的服务端地址。WebSocket 链路地址:wss://dashscope.aliyuncs.com/api-ws/v1/inference。音视频(RTC)使用时传入 RTC 地址。 | |
| apiKey | string | 是 | 百炼服务API Key,用于服务端鉴权。 | |
| workspaceId | string | 是 | 百炼管控台业务空间 ID(Workspace ID)。 | |
| appId | string | 是 | 客户在百炼管控台创建的应用 ID。 | |
| dialogMode | DialogMode | 是 | 对话模式,取值:PUSH2TALK / TAP2TALK / DUPLEX。 | |
| chainMode | ChainMode | 是 | 链路模式,取值:WEBSOCKET / RTC。 |
Demo 简介
发布产物工程(multimodal-dialog-harmony-V1.4.9-V1.0.0)含以下页面:
- ConfigPage 入口页面,可修改 url / api_key / workspace_id / app_id 等配置。
- MultimodalSessionPage 多模态会话页面,实现多模态实时交互与 VQA(图生文)功能。Demo 在此页面支持"拍照识别xxx"VQA 功能:
- 拍照后上送图片链接或 base64 数据(图片 ≤ 180KB),触发单张图片的识别与对话。
- Demo 在音视频交互模式下,通过外部采集的方式输入图像序列,方便眼镜等 IoT 设备的采集和视频对话接入。
接口设计
MultiModalDialog 对话入口类
MultiModalDialog 初始化对话类,传入必要的全局参数。- setContext
UIAbilityContext,在调用 createConversation 前必须先调用本方法。
- createConversation
- start
- stop
- destroy
- setDialogTimeout
- interrupt
- startSpeech / stopSpeech / cancelSpeech
- sendAudioData
- sendRefData
- requestToRespond
- sendVideoFrame
- sendResponseStarted / sendResponseEnded
- 其他接口
- 静态配置接口(RTC 音视频采集开关)
关键参数枚举
| 参数 | 值 | 说明 |
|---|---|---|
| ChainMode | WEBSOCKET | WebSocket 链路(支持 AudioOnly 和 AudioAndVideo) |
| RTC | RTC 链路(音视频链路) | |
| DialogMode | PUSH2TALK | 手动开始、手动结束 |
| TAP2TALK | 手动开始、自动判断结束 | |
| DUPLEX | 全双工交互 |
MultiModalRequestParam.builder() 的方法列表。上行、下行、客户端信息和业务参数分别通过 upStream、downStream、clientInfo 和 bizParams 配置;上、下行参数中没有独立设置方法的协议参数可通过相应对象的 passThroughParams 传入。
| 字段路径 | 类型 | 是否必选 | 说明 |
|---|---|---|---|
| header.action | string | 是 | 请求动作,固定为 "run-task" |
| header.task_id | string | 是 | 任务 ID,UUID |
| header.streaming | string | 是 | 流式方式,固定为 duplex |
| payload.task_group | string | 是 | 任务组名称,固定为 "aigc" |
| payload.task | string | 是 | 任务名称,固定为 "multimodal-generation" |
| payload.function | string | 是 | 调用功能,固定为 "generation" |
| payload.model | string | 是 | 模型名称,固定为 "multimodal-dialog" |
| payload.input.directive | string | 是 | 请求指令 |
| payload.input.workspace_id | string | 是 | 业务空间 ID |
| payload.input.app_id | string | 是 | 应用 ID |
| payload.input.dialog_id | string | 否 | 对话 ID |
| payload.parameters.upstream | object | 是 | 上行参数 |
| payload.parameters.downstream | object | 否 | 下行参数 |
| payload.parameters.client_info | object | 是 | 客户端信息 |
| payload.parameters.biz_params | object | 否 | 业务参数 |
| 一级参数 | 类型 | 是否必选 | 说明 |
|---|---|---|---|
| type | string | 是 | 上行类型:AudioOnly 仅语音通话;AudioAndVideo 音视频 |
| mode | string | 否 | 客户端使用的模式,默认 tap2talk:push2talk / tap2talk / duplex |
| audio_format | string | 否 | 音频格式,支持 pcm、raw-opus,默认为 pcm |
| sample_rate | int | 否 | 语音识别的采样率:8000 / 16000 / 24000 / 48000,默认 16000 |
| vocabulary_id | string | 否 | 热词 ID,设置该参数会覆盖管控台热词配置 |
| language | string | 否 | 语音识别语种,默认与控制台保持一致 |
| 参数 | 类型 | 是否必选 | 说明 |
|---|---|---|---|
| voice | string | 否 | 合成语音的音色,支持范围取决于用户在管控台选择的语音合成模型 |
| sample_rate | int | 否 | 合成语音的采样率:8000 / 16000 / 24000 / 48000。SDK 的 DownStream 默认值为 24000。千问 TTS 模型仅支持 24000 |
| audio_format | string | 否 | 音频格式,支持 pcm / opus / raw-opus,默认为 pcm;千问-TTS 模型仅支持 pcm |
| frame_size | int | 否 | 合成音频的帧大小:10/20/40/60/100/120,默认 60ms,仅在 opus 或 raw-opus 时生效 |
| volume | int | 否 | 合成音频的音量 0-100,默认 50 |
| speech_rate | int | 否 | 合成音频语速 50-200,默认 100 |
| pitch_rate | int | 否 | 合成音频声调 50-200,默认 100 |
| bit_rate | int | 否 | 合成音频比特率 6~510 kbps,默认 32,仅 mp3/opus/raw-opus 生效 |
| intermediate_text | string | 否 | 控制返回的中间文本:transcript(用户语音识别结果)/ dialog(对话回答中间结果),可逗号分隔,默认 transcript |
| word_timestamp_enabled | boolean | 否 | 是否下发 TTS 合成音频对应的时间戳,默认 false,返回于 RespondingContent.extra_info |
| transmit_rate_limit | int | 否 | 下发音频发送速率限制,单位字节每秒 |
| incremental_response | boolean | 否 | 是否增量返回大模型结果,默认 false 全量 |
| instruction | string | 否 | 设置指令,用于控制方言、情感等合成效果 |
| language | string | 否 | 语音合成语种,默认与控制台一致 |
| 一级参数 | 二级参数 | 类型 | 是否必选 | 说明 |
|---|---|---|---|---|
| user_id | string | 是 | 终端用户 ID,客户根据业务规则生成,最大长度 36 字符 | |
| device | uuid | string | 否 | 客户端全局唯一 ID,最大 40 字符;一个用户可多个设备,uuid 不同但 user_id 相同 |
| network | ip | string | 否 | 调用方公网 IP |
| location | latitude | string | 否 | 调用方纬度信息 |
| longitude | string | 否 | 调用方经度信息 | |
| city_name | string | 否 | 调用方所在城市 |
| 一级参数 | 二级参数 | 类型 | 是否必选 | 说明 |
|---|---|---|---|---|
| user_defined_params | json object | 否 | 需透传给 agent 和 mcp 服务的参数。可在 extra_config 子节点设置 enable_web_search(是否开启联网搜索)、agent_timeout(agent 连接超时 10-120 秒,默认 10) | |
| user_prompt_params | json object | 否 | 设置用户自定义 prompt 变量,由用户自定义 json 的 key 和 value | |
| user_query_params | json object | 否 | 设置用户自定义对话变量,由用户自定义 json 的 key 和 value |
IDialogCallback(回调接口)
HarmonyOS 对话回调接口为 IDialogCallback,通过 createConversation 传入的回调查看对话状态与事件。
onConvEventCallback AI对话 Response详情
- EVENT_HUMAN_SPEAKING_DETAIL
- EVENT_RESPONDING_DETAIL
payload.output.text 返回 AI 回复文本。示例:
异常处理
onErrorReceived - response
对话异常通过onErrorReceived 回调上抛:
通用错误码
HarmonyOS SDK 通用错误码,如遇报错问题,请参见文档多模态实时交互错误码进行排查。
调用时序
全双工交互
sendAudioData 持续上送;下行合成音频通过 onSynthesizedSpeech 回调交给应用播放。播放时保持录音上送,支持随时说话打断。
半双工交互
更多 SDK 接口使用说明
双工交互
HarmonyOS SDK 支持 Duplex 全双工交互模式。在 WebSocket 双工模式下,应用在播放 AI 语音回复时持续采集并上送录音,支持随时说话打断。
- 在音频交互模式下,通过
MultiModalDialog构造方法传入DialogMode.DUPLEX开启全双工。 - 双工交互需要回声消除(AEC)。HarmonyOS SDK 集成了内部 AEC,默认关闭,需通过
MultiModalDialog.wsUseInternalAEC = true显式开启(未开启时使用外部 AEC);应用需将下行 TTS 播放数据通过sendRefData作为回声参考上送。
VQA 交互
VQA 是在对话过程中通过发送图片实现图片+语音的多模交互的功能。
核心过程是语音请求拍照意图触发 "visual_qa" 拍照指令。当客户端通过回调 onConvEventCallback 收到拍照指令后,发送图片链接或者 base64 数据(支持小于 180KB 的图片)即可实现对话过程中的图片理解。
通过 WebSocket 链路请求 LiveAI
LiveAI(视频通话)是百炼多模态实时交互的官方 Agent。通过 WebSocket 链路调用 LiveAI 时,SDK 使用 AudioAndVideo 上行类型持续上送视频帧。
sendVideoFrame / PushExternalVideoFrame)在 WebSocket 链路的图像交互只支持 base64 编码,每张图片大小在 180KB 以下;如需实时视频通话,请改用 RTC 链路(ChainMode.RTC),由 SDK 内置摄像头采集并推流。
TTS 文本合成
TTS 是文本合成语音的能力,HarmonyOS SDK 通过 requestToRespond 请求服务端合成音频。
自定义提示词变量和传值
- 在管控台项目【提示词】配置自定义提示词变量。
user_name 变量代表用户昵称,以 ${user_name} 形式插入 Prompt 中。
- 在代码中设置:
ASR 结果即时纠错
在对话过程中,ASR 识别结果有可能出现错误或者非预期的结果。除了配置热词之外,也可以通过即时纠错功能接口上传纠错词表进行实时干预。
参数说明:
| 参数 | 一级参数 | 二级参数 | 类型 | 说明 |
|---|---|---|---|---|
| asrPostProcessing | ReplaceWord[] | SDK 上行参数中的 ASR 纠错词表 | ||
| ReplaceWord | Object | 每个 ReplaceWord 对应一组词的替换规则 | ||
| source | String | 需要被替换的文本 | ||
| target | String | 替换目标文本 | ||
| matchMode | String | 匹配模式:exact(整句精确匹配)/ partial(部分匹配),默认 exact |