输入一句场景创意,wan3.0-video 一次生成 30 秒、1080P、16:9 的电影级空镜,运镜、光影与配乐原生同步生成。
免责声明:本页展示内容均为 AI 模型生成,仅供参考,不构成任何效果承诺;实际产出效果与 Credits 消耗以控制台“用量详情”为准。
wan3.0-video 一次生成 30 秒、1080P 的电影级长镜头,运镜、光影推移、配乐与环境音都由模型原生产出,不用后期剪辑合成。本篇以“仙山云海”为例,方法同样适用于山河、城市、季节质感与品牌氛围开场。
调用链:qwen3.8-flash(可选,把主题创意扩写成电影感提示词)→ wan3.0-video(纯文本输入,一次生成 30 秒 / 1080P / 16:9,原生音画同步)。
实测产出
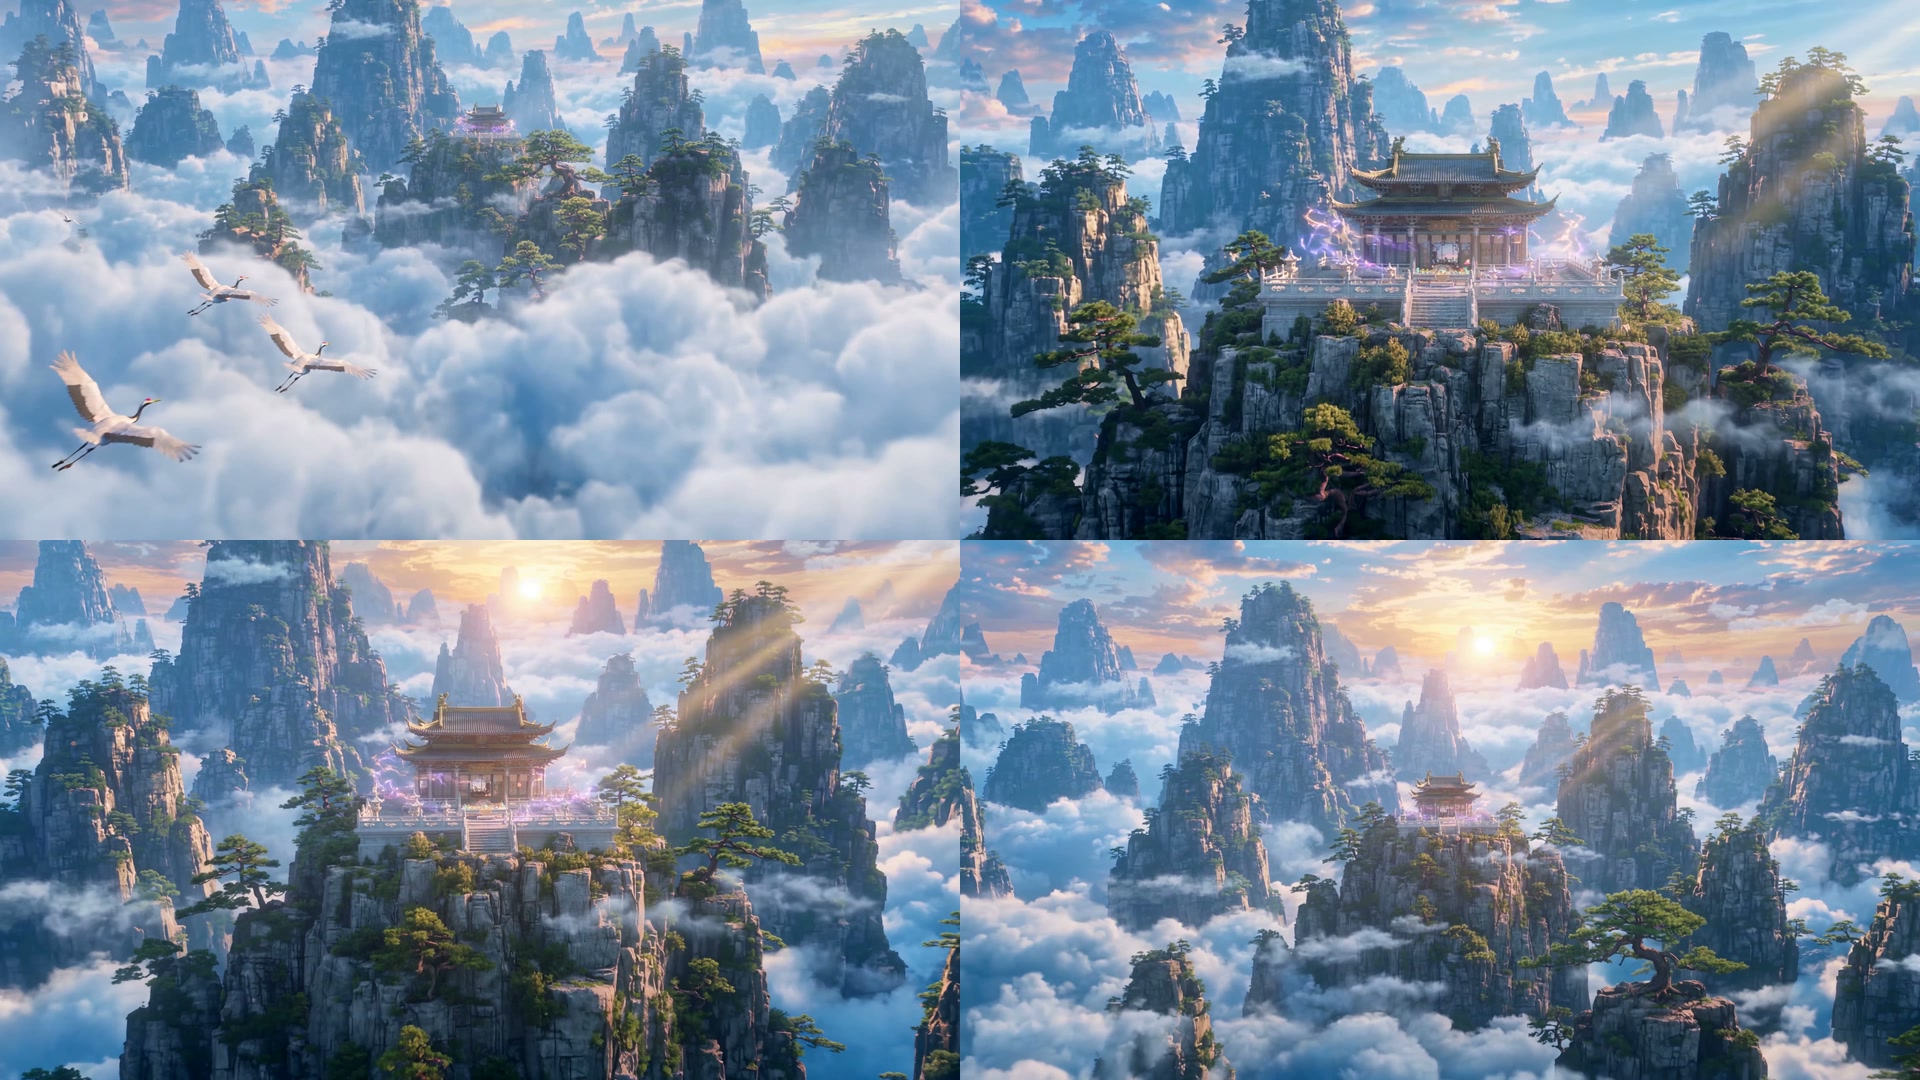
本次一次生成 30 秒成片:镜头自高空掠过云海、抵近峰顶仙宫、俯瞰阁前平台,再拉远升高,收束于楼阁隐入群峰的云海朝阳远景。成片为一次调用的完整输出,未经后期处理;画面 1920×1080 / 30fps,自带与画面同步的立体声配乐与环境音,全程无静音段、无台词、无旁白。页面内嵌视频为便于加载的 540p 压缩预览,生成参数为 1080P。
四拍关键帧对应成片的画面节拍:约 1 秒高空俯瞰群峰与鹤群,约 11 秒镜头推进抵近仙宫楼阁,约 24 秒拉远俯瞰峰顶平台与宴席,约 28 秒远景定格于云海朝阳。
| 项目 | 实测值 |
|---|---|
| 模型与形态 | wan3.0-video · 文生视频(纯文本输入,无首帧图、无参考素材) |
| 生成参数 | duration 30 · resolution 1080P · ratio 16:9 · --watermark false |
| 成片规格 | 1920×1080 / 30fps / 30.0 秒,H.264 视频 + AAC 立体声 |
| 产出 | 1 条 30 秒成片,含模型原生配乐与环境音 |
步骤:一句创意到 30 秒成片
两点通用设置:全部视频命令加 --watermark false 关闭模型在右下角的“AI 生成”水印;CLI 不额外叠加水印。30 秒 1080P 长片的生成时长在十分钟量级,用 --async 先取 task_id,再手动轮询,避免客户端轮询超时。
设置 Token Plan 的 Base URL 和 API Key。Token Plan 的 Key 以 sk-sp- 开头,需与 Token Plan Base URL 配套使用:
①(可选)把主题创意扩写成电影感提示词
② 一次生成 30 秒 1080P 成片
说明
- 按一条 30 秒整片设计叙事:30 秒是
wan3.0-video的单次生成上限。更长的成片需要多次生成再拼接,而每次生成会自动配上不同的配乐与环境音,跨调用的配乐与画面风格不保证一致,拼接处音画会突变。 - 空镜要显式约束“无对白”:提示词末尾没有写“无对白、无字幕、无人物特写”时,模型可能自行生成人声或字幕。需要画外音时,把台词直接写进提示词,由模型原生生成人声与口型。
- 合规边界:演示中的仙山、云海、仙宫宴席均为模型生成的虚构画面,不含真实人物肖像、真实地标与第三方商标。本页成片按
--watermark false生成,不含“AI 生成”水印;需要保留该标识时,省略此参数(使用 Profile 配置,CLI 默认 true)或传--watermark true。对外发布 AI 生成内容时,请遵守适用的 AI 生成内容标识要求;本页关闭水印仅用于演示素材制作。