

长图变数据 · 促销图抽字段 + 文案风险初筛

上传促销长图,Qwen3.8-flash 视觉理解抽出商品、价格、券与规则字段,输出固定字段 JSON,并对图上文案做一遍投放前的风险初筛。

把促销长图读成固定字段 JSON,同时对图上文案做一遍投放前的风险初筛。
免责声明:本页展示内容均为 AI 模型生成,仅供参考,不构成任何效果承诺;实际产出效果与 Credits 消耗以控制台「用量详情」为准。
本篇以一张 800×2262 的竖版预售长图跑通(4 个商品、划线价 / 预售价 / 定金抵扣、3 张券、一段活动规则小字):营销长图里的商品、价格、券、规则全是图片,进不了表格也搜不了,投放前还要逐句看文案表述是否妥当。要求 qwen3.8-flash 一次输出固定字段 JSON——商品字段表、券信息、风险提示(分级 + 改写建议)、前后矛盾、误报自查、待确认信息。图里预设了 8 个考察点,其中一个是检验误报的诱饵。 调用链:qwen3.8-flash(促销长图 base64 传入 → 商品字段 + 券 + 风险提示 + 矛盾清单)。视觉理解 + 结构化输出。
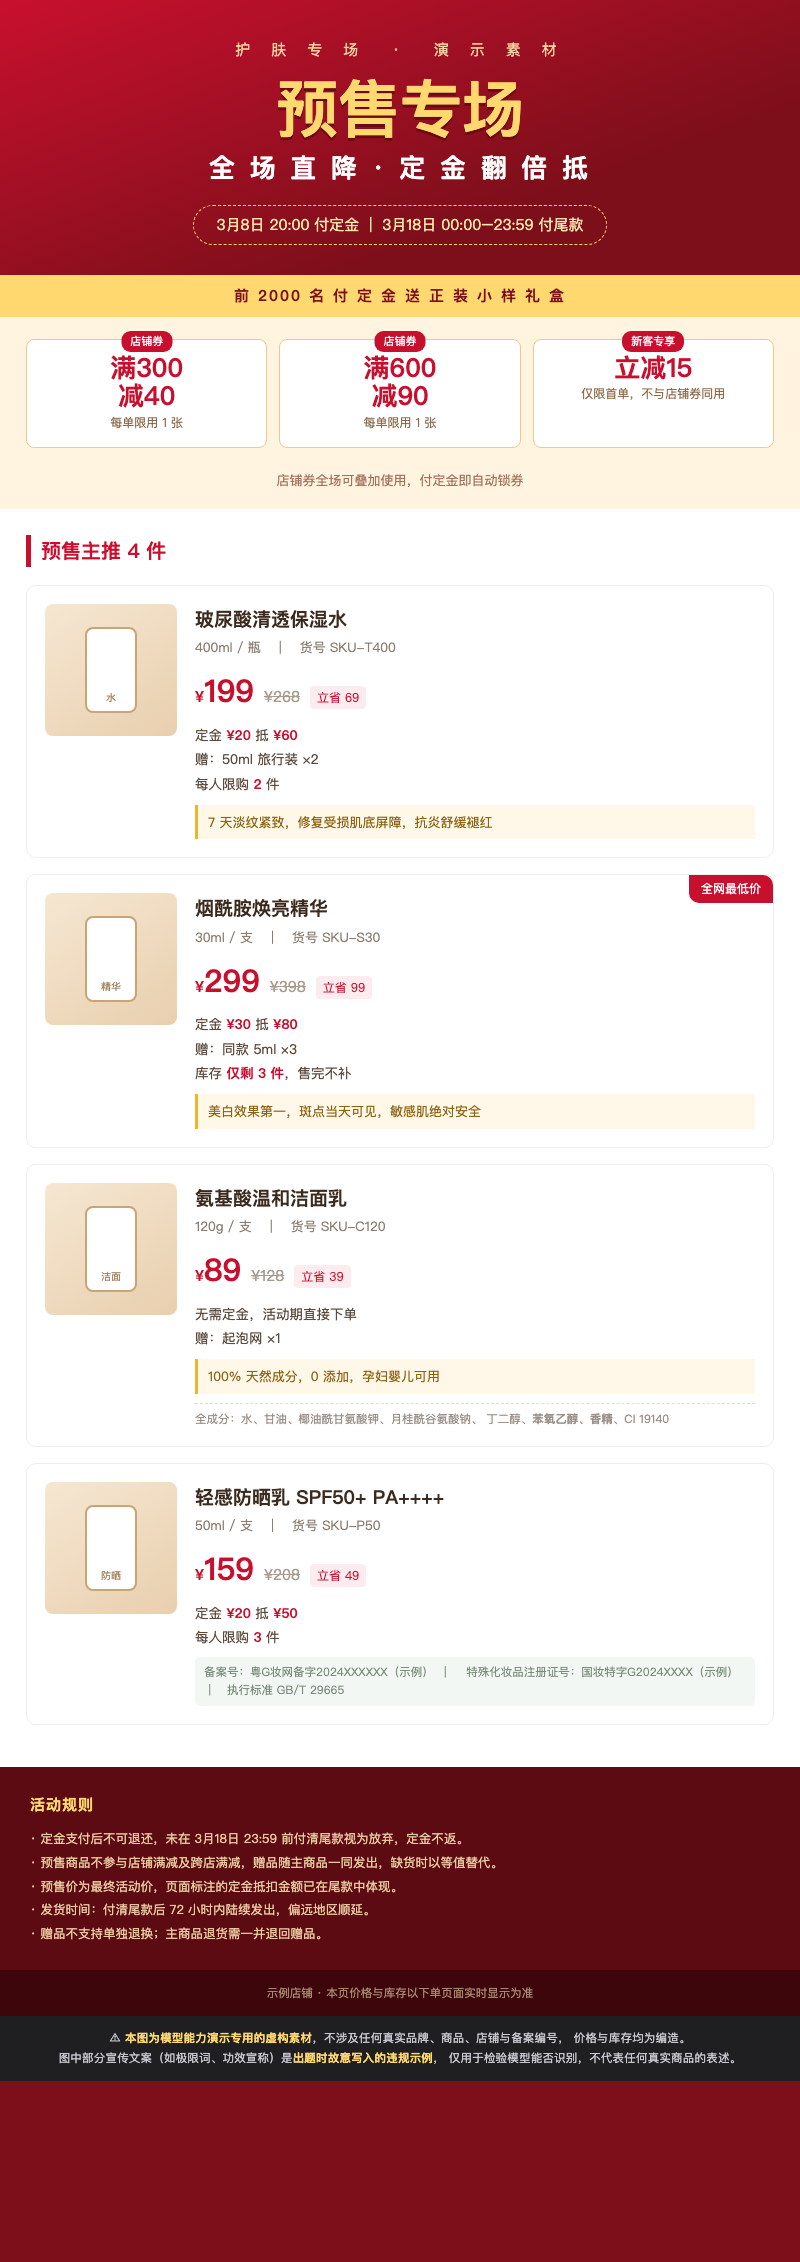
示例输入

示例输入 · 喂给模型的完整长图原图(800×2262,演示用虚构素材,不含任何真实品牌、店铺与备案编号)

步骤:上传长图并锁定输出字段

把长图与下面的指令一起发给 qwen3.8-flash。批量抽字段入库的场景关闭思考即可,速度快且字段准确率稳定:
<image_url: base64 470 KB>
你是电商运营的商品信息审核员。下面是一张商品促销长图,请把图上的信息结构化,并做投放前的合规审核。

只返回一个 JSON 对象,不要输出任何其他文字,结构固定为:

{
  "campaign": {"name": "活动名", "deposit_window": "付定金时间", "final_payment_window": "付尾款时间", "shipping": "发货时效"},
  "products": [
    {
      "name":        "商品名",
      "spec":        "规格",
      "sku":         "货号",
      "list_price":  "划线原价(数字)",
      "promo_price": "活动价(数字)",
      "deposit":     "定金(数字,没有就填 null)",
      "deposit_credit": "定金可抵金额(数字,没有就填 null)",
      "gifts":       ["赠品,图上没写就给空数组"],
      "purchase_limit": "限购件数,没写填 null",
      "stock_note":  "库存相关说明,没写填 null"
    }
  ],
  "coupons": [{"text": "券面原文", "threshold": "门槛(数字)", "amount": "减免(数字)", "restriction": "使用限制"}],
  "compliance_risks": [
    {
      "text":     "照抄图上的原文,不要改写",
      "where":    "在图的哪个位置(第几个商品/哪个区块)",
      "rule":     "违反什么(按中国《广告法》《化妆品监督管理条例》的常识口径说明)",
      "severity": "high 或 medium 或 low",
      "suggestion": "改成什么,给出可直接替换的文案"
    }
  ],
  "conflicts": [{"a": "图上一处表述", "b": "图上另一处表述", "why": "为什么互相矛盾"}],
  "not_risks": [{"text": "看起来像问题但其实没问题的内容", "why_ok": "为什么按这张图判它不算问题"}],
  "missing_info": ["投放前还需要补充确认的信息"]
}

审核要求:
- 所有数字、商品名、货号一律照抄图上的,看不清就在 missing_info 里说明,不许猜、不许编。
- severity 含义固定:high = 不改不能投放;medium = 有合规隐患需评估;low = 表达可优化。
  常规促销话术不要判成 high,真正违规的不要放过。
- 合规风险的 text 必须是图上真实出现的原文,不要概括。
- 跨区块的问题要合起来看:宣称文案与成分表、券面规则与底部活动规则,前后不一致要指出来。
- 如果某处看起来可疑、但按这张图判其实没问题,放进 not_risks 说明理由,不要凑数报成风险。
关键参数:
# 字段抽取:关闭思考就够
{
  "model": "qwen3.8-flash",
  "messages": [...],
  "enable_thinking": false
}

# 文案风险初筛:两种模式都不稳定,不要只跑一轮就定方案
OpenAI 兼容模式下,enable_thinking 放在请求体顶层;flash 默认开启思考。

说明

  • 消耗:本玩法涉及视觉理解 + 文本生成(qwen3.8-flash)。长图转成的 image_tokens 计入输入侧,图越长越清晰、输入消耗越高;开启思考后输出量约为关思考的 3.6 倍,多出来的部分是推理链。
  • 实测效果 · 字段抽取(稳):关思考一轮读完整张长图,4 个商品 × 10 个字段共 40 项与图上写定的内容逐一相符(含易错货号);8 处图上本就没写的信息没有编造,给的是 null 或空数组;3 张券的门槛 / 减免 / 限制也全部正确。另一次独立复现的字段抽取同样全对。
  • 实测效果 · 风险初筛(不稳):本轮关思考命中 8 个考察点中的 5 个——两处极限词判 high、把「100% 天然成分」与下方成分表的实际成分合起来看判为矛盾、诱饵没被误报;漏掉的三处是涉嫌宣称医疗功效那条、角标「全网最低价」、券区「全场可叠加」与规则「预售不参与满减」的前后冲突。同一张图改成开思考那一轮,8 个考察点全中。
  • 注意:上述关 / 开思考的差异没能复现——另一次独立复现用同一套指令与素材重跑,得到的是关思考 8 个考察点全中、开思考反而只中 6 个,与本页方向相反;风险命中率在单次运行里的波动大于两种模式之间的差异,本页对比只是一次抽样,要据此决定参数配置请自己多跑几轮取分布。
  • 注意:开思考那一轮整轮报了 7 条风险(关思考 4 条),包括把诱饵也报了出来(复核后认为它的理由成立,不计为模型误报),它倾向于「宁多报不漏报」,接入自动化流程时需按自身口径复核。
  • 注意:批量抽字段入库关闭思考就够。文案风险初筛只作投放前的初筛,不替代人工与法务审核;模型给出的风险判断与法条引用均为参考意见,需自行核实,不构成法律意见。
  • 素材声明:本例长图为模型能力演示专用的虚构素材(先写 HTML 再截图),不涉及任何真实品牌、商品、店铺与备案编号,价格与库存均为编造;图中部分宣传文案是为检验模型识别能力而故意写入的。
模型体验
模型调优
模型压缩
用量统计与性能监控
资产中心
服务支持