本文介绍吞吐预留的长输入阶梯系数与前缀缓存折算规则、TPM 容量计算器、容量消耗与缓存命中字段及常见问题。吞吐预留(标准模式与高速模式)均适用。
容量折算
您购买的输入/输出 kTPM(1 kTPM = 1,000 Tokens/分钟)按折算后的消耗扣减,而非原始 token 数:购买 200 kTPM 不等于每分钟可消耗 200K 原始 token。
- 长输入:超出阶梯边界的输入部分按长输入阶梯系数放大计入——50K 输入可能消耗 86 kTPM 额度。
- 前缀缓存:请求间重复的输入前缀被缓存复用,命中部分按缓存折算系数折扣计入——同样 50K 输入可能仅消耗几十 kTPM。
折算规则
先统一三个术语:前缀缓存指系统把请求间相同的输入前缀缓存起来供后续请求复用;某次请求的输入与缓存内容匹配即缓存命中;命中部分计入消耗时乘的折扣就是缓存折算系数。
两类系数分别作用于输入的不同部分:
- 缓存折算系数:只作用于命中缓存的输入 token,乘系数折扣计入(例如系数 0.2 时,30K 命中 token 只计 6 kTPM)。
- 长输入阶梯系数:只作用于超出阶梯边界的部分,乘倍数放大计入;边界内的部分保持 1x 不变(例如 50K 输入落在 (32K,256K] 阶梯时,仅超出的 18K 按 3x 放大)。多数模型的阶梯只作用于输入,个别模型输出也按系数放大(见下表各模型行)。
模型 | 最长输入 Token | 缓存折算系数 | 长输入阶梯系数 |
|---|---|---|---|
qwen3.8-max | 1M | 0.125 | 无阶梯(1.0) |
qwen3.7-flash-2026-07-15 | 1M | 0.2 | 输入输出相同 |
qwen3.7-max-2026-05-20 | 256K | 0.1 | 无阶梯(1.0) |
qwen3.7-plus-2026-05-26 | 256K | 0.2 | 无阶梯(1.0) |
qwen3.6-flash-2026-04-16 | 256K | 1 | 无阶梯(1.0) |
glm-5.3 | 1M | 0.25 | 无阶梯(1.0) |
glm-5.2 | 1M | 0.25 | 无阶梯(1.0) |
deepseek-v4.1-flash | 1M | 0.02 | 无阶梯(1.0) |
deepseek-v4-flash | 256K | 0.1 | 无阶梯(1.0) |
deepseek-v4-flash-0731 | 1M | 0.1 | 无阶梯(1.0) |
deepseek-v4-pro | 256K | 0.08 | 无阶梯(1.0) |
deepseek-v4-pro-0813 | 1M | 0.1 | 无阶梯(1.0) |
kimi-k2.6 | 256K | 0.2 | 无阶梯(1.0) |
qwen3.8-flash | 1M | 0.125 | 无阶梯(1.0) |
glm-5.1 | 200K | 0.2 | 输入>32K 1.33x |
其他模型 | 以控制台为准 | 以控制台为准 | 以控制台为准 |
- 长输入阶梯·Qwen3.7-Flash
- 前缀缓存·GLM-5.2
- 双系数·GLM-5.1
50K 输入、无缓存命中,按阶梯边界拆开算:
- 未超出 32K 的部分按 1x 计入:
32K × 1= 32 kTPM。 - 超出的 18K 按 3x 计入:
18K × 3= 54 kTPM。 - 消耗合计
32 + 54= 86 kTPM。
- 命中的 30K 在 1x 阶梯内、再乘 0.2:
30K × 1 × 0.2= 6 kTPM。 - 前 32K 中未命中的 2K 按 1x 计入:
2K × 1= 2 kTPM。 - 超出的 18K 按 3x 计入:
18K × 3= 54 kTPM。 - 消耗合计
6 + 2 + 54= 62 kTPM,比无缓存少约 28%。
容量估算
购买前可用 TPM 容量计算器估算所需容量:填入预期业务负载,即可得到建议购买的输入/输出 kTPM。
| 参数 | 填什么 | 对建议值的影响 |
|---|---|---|
| 每分钟请求数(RPM) | 业务高峰期每分钟的请求数 | RPM 越大,输入/输出建议值同步越大 |
| 平均输入长度(token) | 单条请求的平均输入 token 数 | 输入越长,输入建议值越高 |
| 平均输出长度(token) | 单条请求的平均输出 token 数 | 输出越长,输出建议值越高 |
| 缓存命中率 | 预期命中前缀缓存的比例 | 只压低输入建议值,不影响输出建议值 |

控制台查看消耗
在百炼控制台的吞吐预留页面,展开目标模型卡片,概览与监控两个页签展示折算消耗的运行情况:
概览:利用率与超额降级
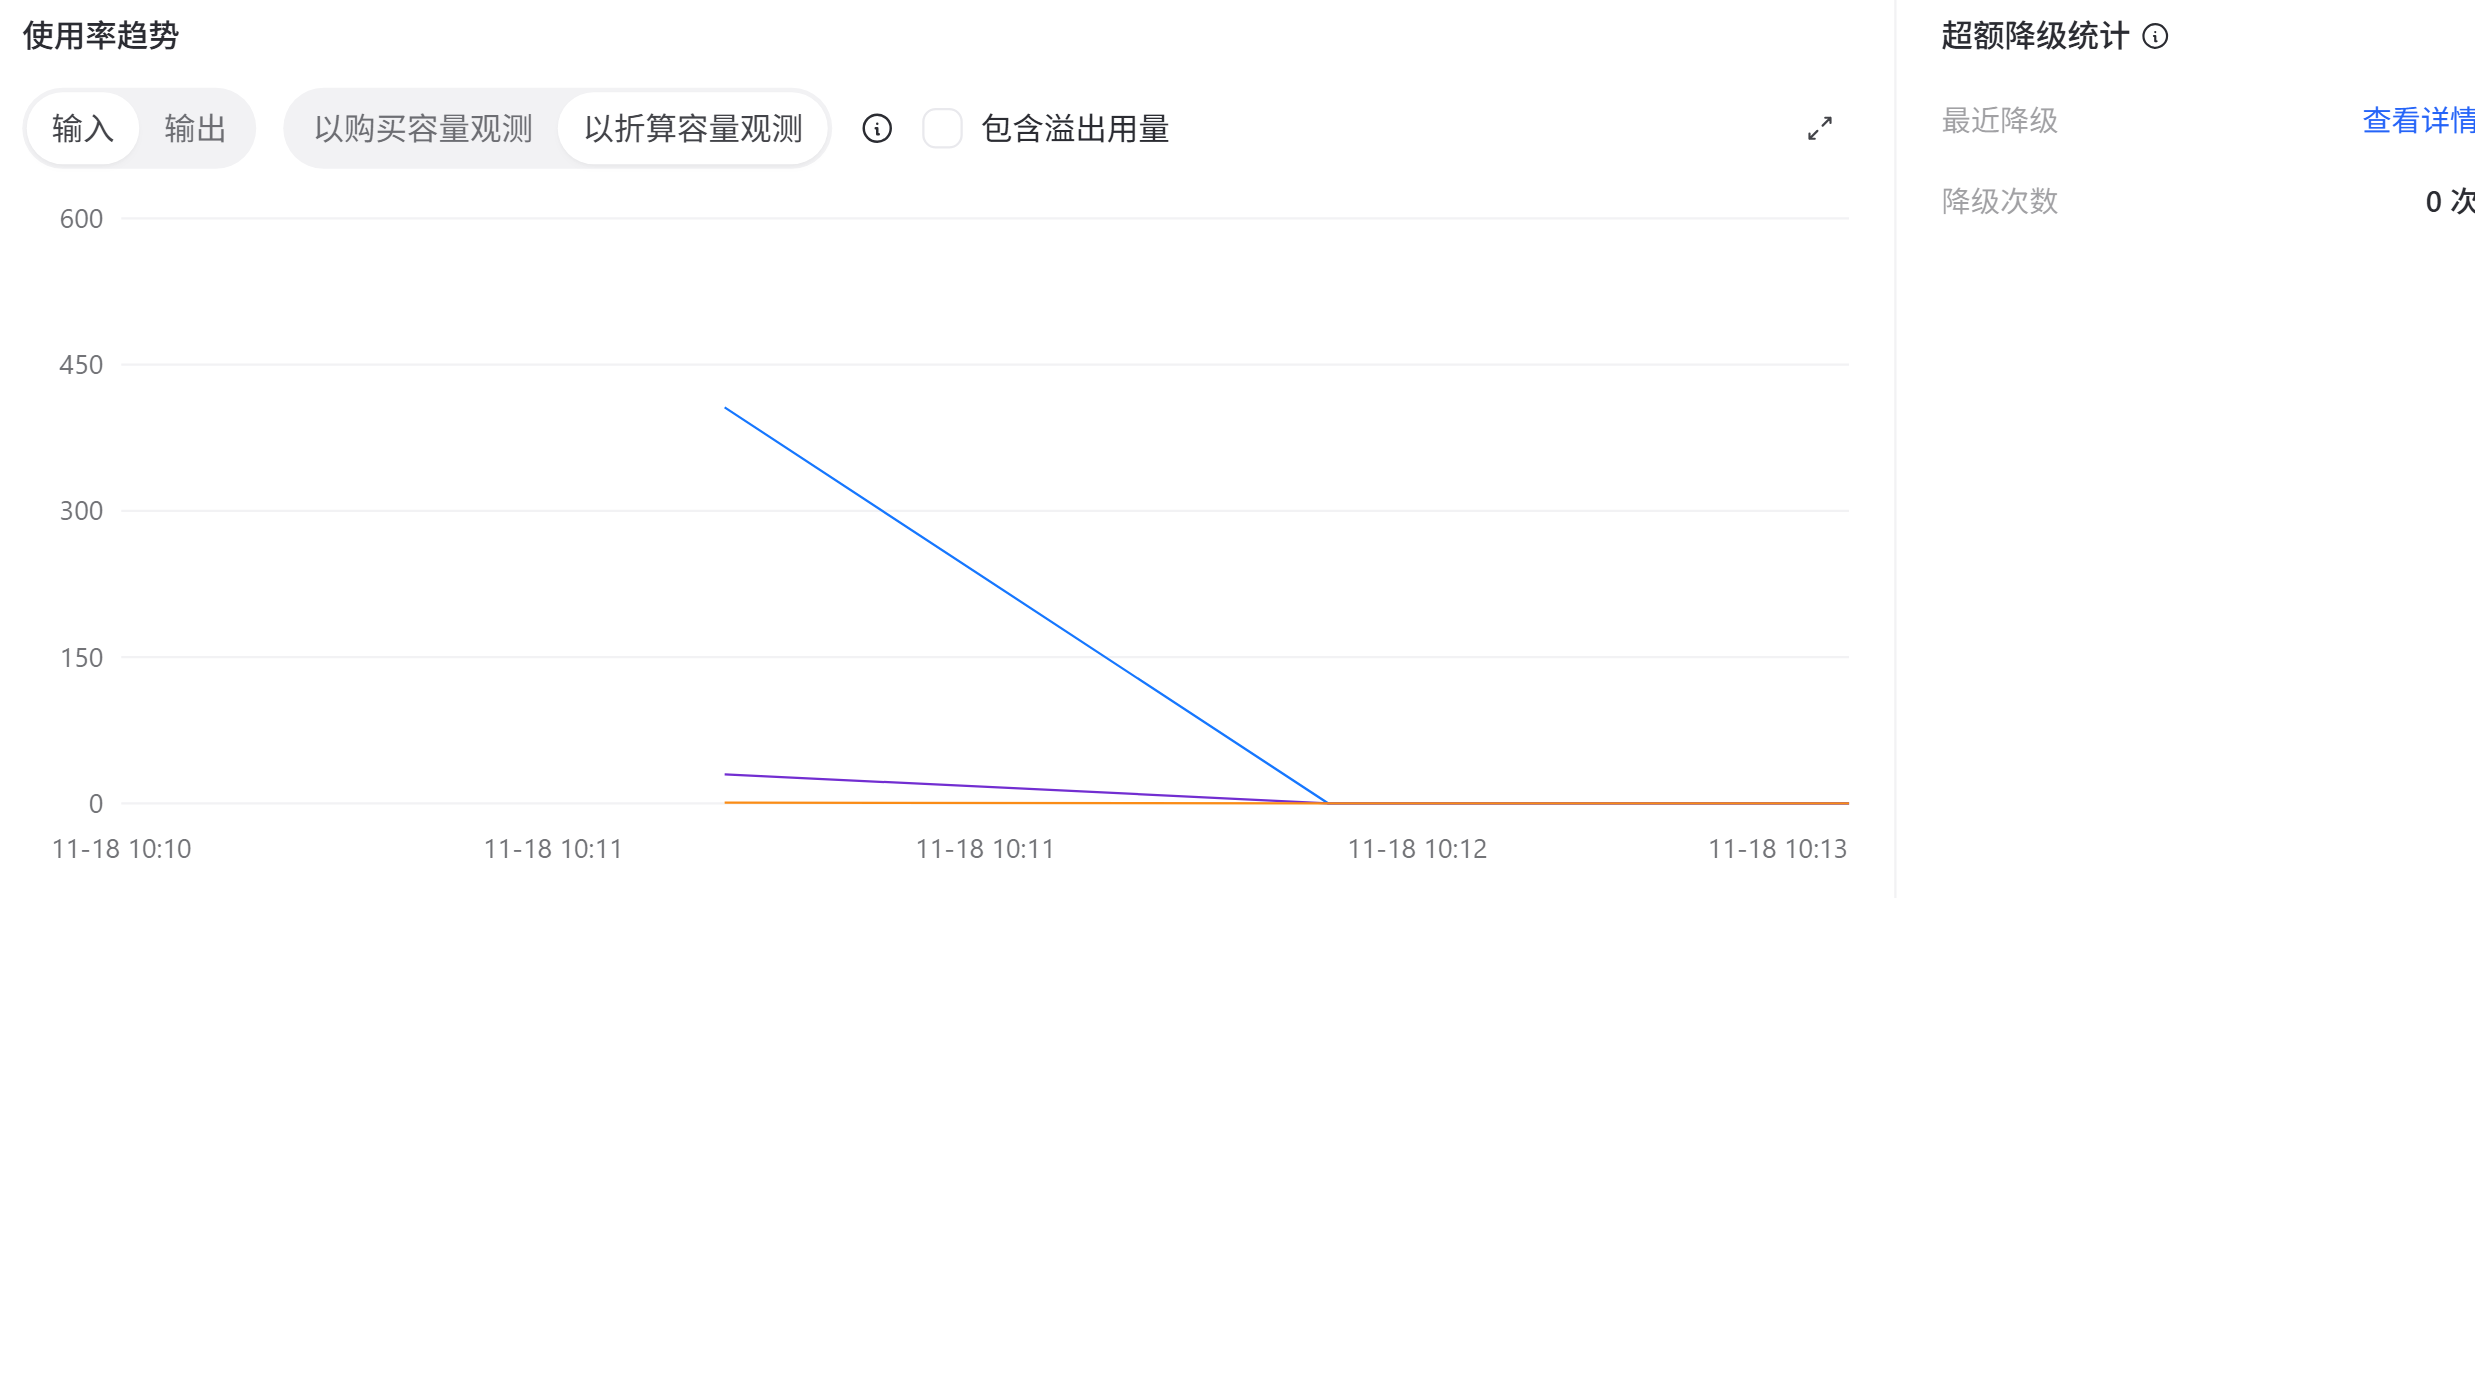
- 使用率趋势:打开以折算容量观测开关后,曲线即本页折算方式计算的消耗。三种统计方式:
- 以购买容量观测:以购买容量为基准,用于核对购买量是否够用。
- 以折算容量观测:以折算后容量为基准,反映长输入与缓存折算的实际效果。
- 包含溢出用量:用量中额外计入溢出到按量计费的部分。
- 超额降级统计:折算消耗超出购买容量后被降级处理的次数——长输入被阶梯放大正是超额降级的常见原因。
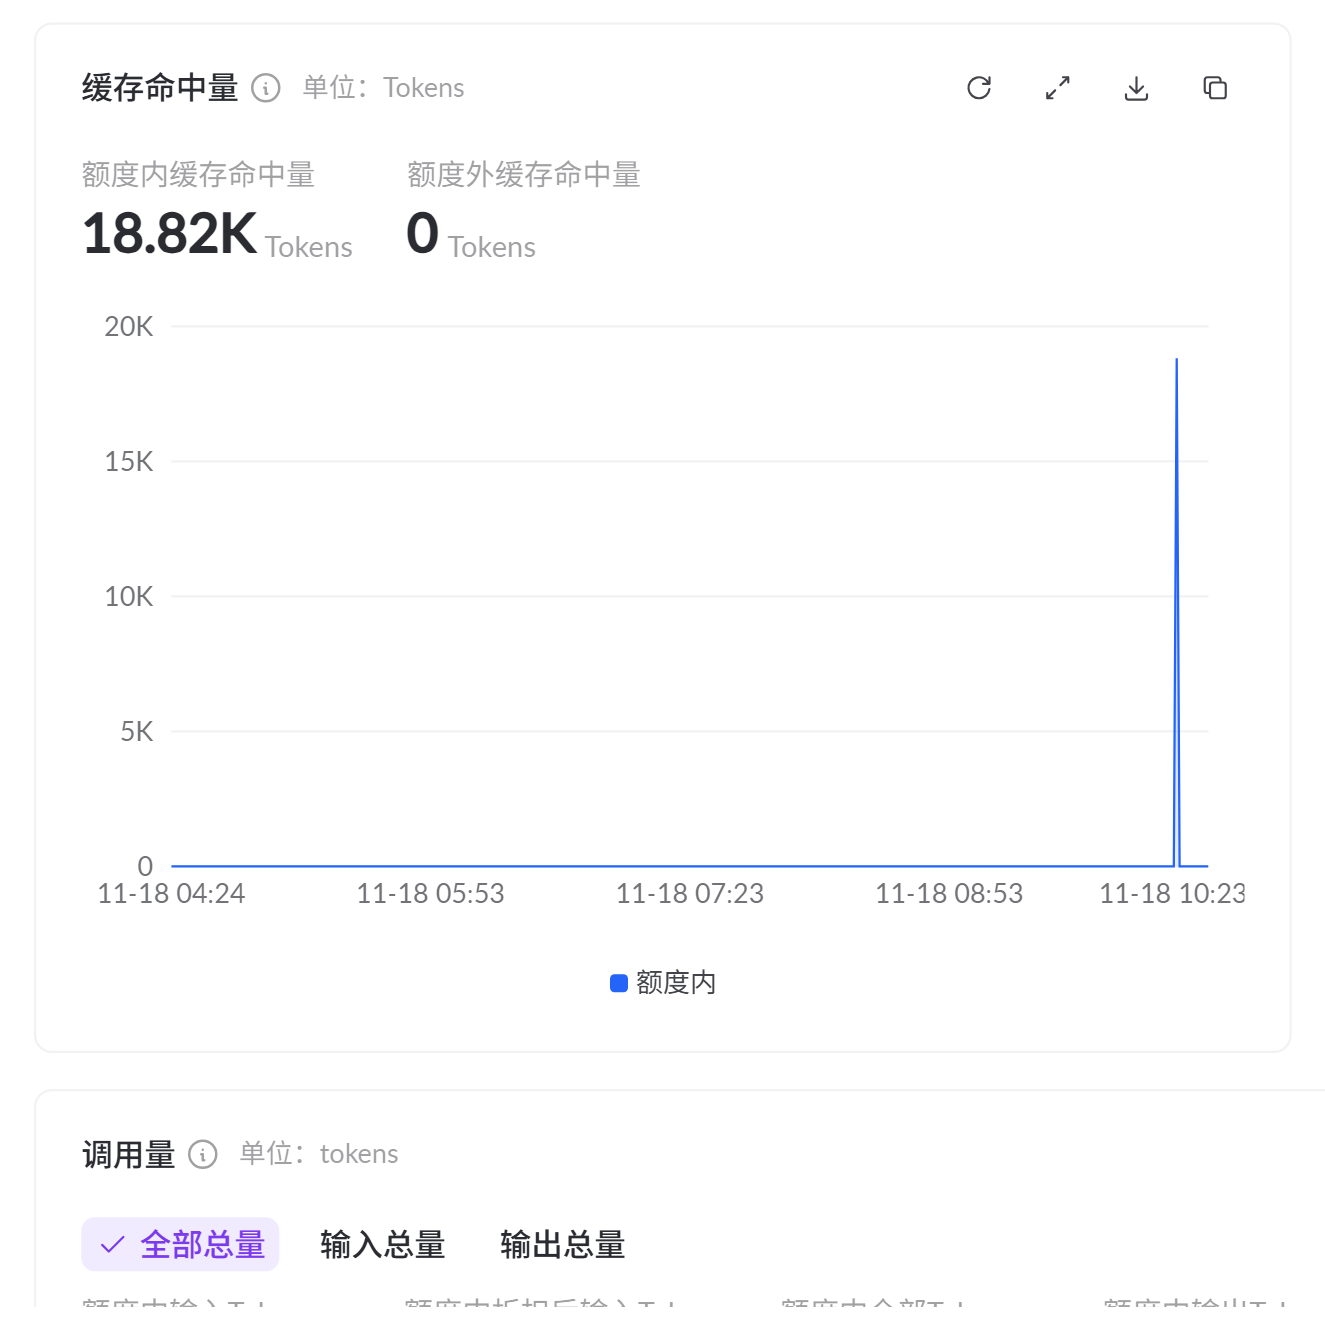
监控:缓存命中
API 查看实际消耗
用专属模型 code 发起调用后,响应中有三个字段分别说明:是否命中预留容量、消耗了多少折算容量、缓存命中情况:
| 字段 | 含义 |
|---|---|
service_tier | 本次计费方式:ptu_default = 消耗标准模式预留容量,ptu_fast = 消耗高速模式预留容量,null 或不返回 = 未命中预留容量,按量计费 |
provisioned_tokens | 本次消耗的预留容量 token 数,已是折算后的值(含长输入阶梯与缓存折算) |
cached_tokens | 输入中命中前缀缓存的 token 数,大于 0 即缓存生效;机制与限制见上下文缓存 |
- OpenAI Chat 兼容
- OpenAI Responses
- Anthropic 兼容
- DashScope 原生
| 字段 | JSON 路径 |
|---|---|
cached_tokens | usage.prompt_tokens_details.cached_tokens |
provisioned_tokens(输入侧) | usage.prompt_tokens_details.provisioned_tokens |
provisioned_tokens(输出侧) | usage.completion_tokens_details.provisioned_tokens |
常见问题
Q: 单次输入超过模型上限会怎样?
Q: 单次输入超过模型上限会怎样?
该请求不再消耗预留容量:自动溢出策略下自动转为按量计费;仅使用预留容量策略下返回 429 限流错误。各模型上限见上方系数表的最长输入 Token列。
Q: 利用率为什么会超过 100%?
Q: 利用率为什么会超过 100%?
利用率 = 折算后消耗 ÷ 购买容量。长输入阶梯系数会把 50K 输入放大成 86 kTPM 这类折算值,折算消耗的速度超过购买容量时利用率就越过 100%,超出部分自动转按量计费(或按策略返回 429)。此时应扩容,或提高缓存命中率来压低折算消耗。
Q: 如何确认前缀缓存已生效?
Q: 如何确认前缀缓存已生效?
看响应中的
cached_tokens:大于 0 即本次输入有命中缓存的部分,命中部分按模型的缓存折算系数折扣计耗(系数见折算规则);控制台监控页签的缓存命中率曲线可看长期趋势。Q: cached_tokens 一直是 0,怎么排查?
Q: cached_tokens 一直是 0,怎么排查?
依次检查:请求间的输入前缀是否一致(例如 System Message 被改动)、两次请求的间隔是否超过缓存有效期、单次输入 token 数是否足以触发缓存。完整限制与排查方法见上下文缓存。